
memory-eternal
Your AI forgets every session. Give it a memory you can audit: local-first, review-gated agent memory — one SQLite vault for DSH, Claude Code, Codex, Cursor, OpenClaw, Hermes and MengBot (any MCP client), with an immutable audit log and a token ledger. Agents propose, humans approve. MIT, self-hosted, no cloud.
Automatically checked · GitHub checked 2026-11-12
Overview
🧠 memory-eternal —— 给 AI 装一个可信的第二大脑



English · 简体中文(默认)
☁️ 云端记忆(v0.49.10 主打)
记忆库跟着人走,不跟着机器走。 本机库照旧离线可用;登录云端后,同一套知识卡在你的每台设备、每个 Agent 上都能读到 —— 换电脑不用搬家,换客户端不用重新喂上下文。
| 能力 | 你能得到 |
|---|---|
| 一次登录 | MengBot 账号扫码 / 邮箱登录,或在任意实例上签发的访问密钥(me_…) |
| 一人一库 | 云端按 owner 分目录,每个用户一个独立 SQLite(cloud-vaults/{owner}/memory-eternal.db),物理隔离 |
| 换库不重启 | 本地库 ↔ 云端库热切换(POST /vaults/switch):知识卡、星图、待审、回收站一次性换源,不刷新页面 |
| 上传 / 下载 | 整库复制(本机 → 云端、云端 → 本机),分片传输 + 断点续传 + 中途取消 + 失败重试 3 次,重复内容自动跳过 |
| 离线优先 | 云端不可达自动熔断、回退本地库,首屏最多等 3 秒;本地记忆一分不丢 |
| 自有实例 | 自己的服务器跑 memory-eternal-cloud(systemd / Docker + HTTPS 反代),密钥可签发、可吊销、只存 sha256 |
| 发密钥三处入口 | CLI(dsh-memory cloud keys issue,本地台账模式免令牌)· 面板「🔑 服务端密钥管理」· curl;管理令牌首次启动自动生成 |
# ① 起一个云端实例(默认关闭,不开就是纯本地)
MEMORY_CLOUD=1 node lib/web.js --port 7999     # Docker / systemd 部署见 docs/CLOUD.md
# 首次启动会自动生成管理令牌 → $DSH_HOME/cloud-admin-token(0600,日志打印一次)

# ② 签发访问密钥(三选一)
dsh-memory cloud keys issue --owner alice --note 笔记本   # CLI:能在这台机跑命令就是管理员,免令牌、立即生效
# 或:面板 → 设置 → 🧪 实验性 → 云端连接 → 「🔑 服务端密钥管理」→ 粘贴管理令牌 → 新建
curl -X POST http://127.0.0.1:7999/memory-eternal/api/cloud/keys \
  -H "Authorization: Bearer $MEMORY_CLOUD_ADMIN_TOKEN" \
  -H 'Content-Type: application/json' -d '{"owner":"alice"}'

# ③ 面板:设置 → 🧪 实验性 → 云端连接 → 填地址 + 密钥 → [测试连接] → [保存并切换]
反代 / 容器部署记两个变量:
MEMORY_CLOUD_ADMIN_TOKEN(不配就用自动生成的那把;配了以它为准)、MEMORY_PUBLIC_HOST(写请求的 Host 白名单,填你的域名)。 边界说明:云端服务端(多租户 + 鉴权 + 计费对接)是独立私有组件,不随本开源包发布; 相关接口仍在快速迭代、可能微调。不用云端时,本地功能与之前完全一致 —— 见 docs/CLOUD.md、docs/PRIVATE.md。
📊 与同类产品的实测对比
数据日期 2026-11-18:Stars 取自 GitHub API(整数实值);公开成绩按各自 README / 论文原文口径转录, 不同指标的分数绝不混排。可视化版见 bench/comparison.html,口径与复跑脚本见 bench/COMPARISON.md。
表 1 · 记忆类:综合判断(10 维加权,我们自己的评分口径)
| 排名 | 项目 | 召回 | 语义 | 隐私 | 治理 | 成本 | 总分 |
|---|---|---|---|---|---|---|---|
| 🥇 1 | memory-eternal(Ollama) | 8.6 | 8.6 | 9.5 | 9.0 | 8.0 | 8.54 |
| 🥈 2 | memory-eternal(内置语义) | 7.1 | 6.8 | 9.5 | 9.0 | 9.5 | 8.48 |
| 🥉 3 | Mem0(69.1k★) | 9.3 | 9.0 | 6.0 | 6.0 | 6.5 | 7.49 |
| 4 | MemOS(12.4k★) | 8.5 | 8.5 | 7.0 | 6.0 | 7.0 | 7.38 |
| 5 | graphiti(32.9k★) | 7.8 | 8.5 | 8.0 | 6.0 | 7.0 | 7.26 |
| 6 | basic-memory(4.6k★) | 6.5 | 6.5 | 9.0 | 6.0 | 9.0 | 7.26 |
| 7 | Letta(25.5k★) | 8.0 | 8.5 | 8.0 | 6.0 | 6.5 | 7.22 |
| 8 | mcp-memory-service(2.1k★) | 6.0 | 6.0 | 9.0 | 5.0 | 9.5 | 7.17 |
| 9 | memobase(3.0k★) | 7.2 | 7.0 | 8.0 | 6.0 | 8.0 | 7.15 |
| 10 | cognee(33.4k★) | 8.0 | 8.5 | 8.0 | 5.5 | 7.0 | 7.14 |
| 11 | supermemory(31.6k★) | 8.0 | 8.0 | 6.5 | 5.5 | 6.5 | 7.14 |
| 12 | Zep(5.0k★,产品闭源) | 7.0 | 7.5 | 6.5 | 6.5 | 6.0 | 6.88 |
表 2 · 记忆类:公开基准与部署硬指标
| 项目 | Stars | 公开成绩(原文口径) | 本地 / 零 API | 人工审核闸门 |
|---|---|---|---|---|
| memory-eternal(bge-m3) | 196 | 自建 500 题 R@5 97.2%(检索口径) | 需 Ollama | ✅ |
| memory-eternal(内置) | 196 | 自建 500 题 R@5 95.4%(检索口径) | ✅ / ✅ | ✅ |
| Mem0 | 69,120 | LongMemEval 94.4(托管平台口径,非开源版) | 部分 | 弱 |
| cognee | 33,371 | BEAM 100K 0.79 / BEAM 10M 0.67(0–1) | 部分 | 中 |
| graphiti | 32,889 | 仓库无 LongMemEval / LoCoMo 数字 | 部分 | 中 |
| supermemory | 31,644 | LongMemEval R@15 95%(约 720 token) | 部分 | 弱 |
| Letta ※ | 25,471 | 仓库无 LongMemEval / LoCoMo 数字 | 部分 | 中 |
| MemOS | 12,435 | LongMemEval 89.20(OmniMemEval) | 部分 | 中 |
| Zep ※ | 5,007 | 论文:LongMemEval 准确率比 MemGPT +18.5%、延迟 −90% | ❌ | 中 |
| basic-memory | 4,612 | 仓库无公开记忆基准数字 | ✅ / ✅ | 弱 |
| memobase | 2,960 | LoCoMo 75.78(第三方复现,LLM-Judge Overall) | 部分 | 中 |
| mcp-memory-service | 2,135 | LongMemEval-S R@5 86.0%(零 LLM 调用) | ✅ / ✅ | 弱 |
※ 必须标注的状态:
getzep/zep仓库是 Zep Cloud 的示例 / 集成目录,产品本体闭源(开源图引擎是 graphiti);letta-ai/letta主仓已归档,活跃源码迁到letta-code。这两家不能当"开源版 star"读。
🏷 命令名与别名
包名从一开始就是中性的 memory-eternal;只有命令行工具早期叫 dsh-memory(那时它只服务 DSH)。
现在三种写法是同一个入口:
| 命令 | 用在哪 |
|---|---|
memory | 主名。任何宿主、纯 CLI、脚本里都推荐用它 |
mem | 简短别名,终端里敲得少 |
dsh-memory | 兼容入口。老文档、老脚本、DSH 插件内部仍用它,不会被移除 |
memory status --port 7999      # 等价于 dsh-memory status --port 7999
mem peer code                  # 等价于 dsh-memory peer code
数据目录同理不受限:MEMORY_VAULT_DIR(库目录)、MEMORY_DB_FILE(库文件名)、MEMORY_WEB_PORT(端口)
都可以改,所以库不一定要待在 ~/.dsh 下面。
⚡ 快速开始
# DSH 桌面版 / Web
dsh plugin --profile desktop add memory-eternal     # 重开 DSH → 左栏「记忆」

# 同一套库接 Claude Code / Codex / Cursor(MCP)
npm i -g memory-eternal && dsh-memory connect claude

# 任意 MCP 客户端(MengBot / OpenClaw / Hermes 见 docs/INTEGRATIONS.md)
npx -y -p memory-eternal dsh-memory mcp

# 云端 bot / 远程 agent:直接走 HTTP,不用装进程
curl -s http://127.0.0.1:7999/memory-eternal/api/mcp \
  -H 'content-type: application/json' \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}'

# 浏览器 / 终端
dsh-memory open                             # http://127.0.0.1:7999
npx -y -p memory-eternal dsh-memory tui     # 终端里的实时待审队列
⭐ 如果它帮你少解释了一遍上下文,点个 Star 就是最大的支持
🧾 真的省 token 吗?
大多数记忆产品都说自己省 token。我们认为你应该自己验证。插件内置记忆账本(运行状态 → 记忆账本):
| 记录项 | 含义 |
|---|---|
| 召回:命中数 + 注入字符 | 到底有多少记忆进入了上下文 |
| 沉淀:LLM 调用次数 + 输入/输出字符 | 蒸馏花了你多少成本 |
| 有用率:有用 / 没用 反馈 | 召回的记忆是否真的帮上了忙 |
净收益 ≈ 被避免的上下文开销 −(注入字符 + 蒸馏调用 × 单价)
| 场景 | 你要付 | 你能省 |
|---|---|---|
| 有决策与踩坑记录的多会话项目 | 每次召回约 0.6–0.9k token | 重新解释上下文(约 1.5–3k)或重读文件(3–6k) |
| 一次性问题、低命中率 | 召回注入 | 通常什么也省不到 |
以上是示意数字,不是 benchmark —— 用账本测你自己的。如果召回有用率长期低于约 60%,就调小(更少条数、更短摘要)或直接关掉记忆。 上了云端之后,账本按库独立记账:本地库、云端库各算各的,跨设备看同一份统计。
🛡️ 先审核,再入库
一个「什么都自动吞进去」的记忆系统,迟早会把错误事实当成真相召回。memory-eternal 默认先审后入:
- 新卡先进入待审队列,人工批准后才进主库;
- 在 Web、终端 TUI 或 CLI 里批准 / 驳回 / 批量处理;
- 每次状态变更追加到不可篡改的审计日志(谁 / 什么 / 何时 / 为什么)—— 由 SQLite 层强制,而不是靠约定;
- Agent 可以读取和提议,但不能批准自己写的卡;
- Agent 也可以提交修改:已批准卡的副本进待审队列并标注「✏️ 修改原卡:…」;批准 = 用副本覆盖原卡,驳回 = 原卡一字不动;
- 删除的卡进回收站(默认保留 30 天)。
云端同样是这条闸门:换到云端库只换了数据源,没换规则 —— 云端库里的待审卡一样要人批准。
⭐ 核心记忆
不是所有内容都该每次注入上下文。核心记忆是一组必须每次遵守的偏好与硬约束:
- 任意已批准卡片都可以在阅读器或卡片列表里提升为核心记忆;
- 自动沉淀只会在用户明确要求长期偏好 / 硬约束时建议核心,且 core 候选一律待审;
- 已批准的核心卡每次会话直接注入 systemPrompt,不依赖
memory_recall调用; - 在「设置 → 记忆 → 核心记忆」里可配置条数上限和字符预算;
- 知识星图里核心节点显示为橙色菱形 + ★;
- 不要把密钥 / Token 的值写进核心卡,只保存凭证目录的引用。
🧩 宿主支持(一份库,谁都能用)
同一份 SQLite 库,下面这些宿主都能读写;写入一律进待审队列,审核在 DSH / Web 面板里做(与宿主是谁无关)。
15 个宿主,一张表看全 · ✅ 一键挂载 · ⚠️ 有条件 · ➖ 手填一条 · ❌ 不提供 MCP 配置
🌍 国际主流
| 宿主 | 类型 | 配置位置 | 挂载 |
|---|---|---|---|
| DeepSeek Harness | 插件(内嵌面板) | ~/.dsh/mcp-servers.json | ✅ 装插件即挂 |
| Claude Code | CLI / IDE 插件 | ~/.claude.json | ✅ connect claude |
| Codex CLI / Desktop | CLI | ~/.codex/config.toml | ✅ connect codex |
| Cursor | IDE | ~/.cursor/mcp.json | ✅ connect cursor |
| Windsurf | IDE | ~/.codeium/windsurf/mcp_config.json | ✅ 面板点一下 |
| Cline | VS Code 插件 | ~/.cline/data/settings/cline_mcp_settings.json | ✅ 面板点一下 |
| Gemini CLI | CLI(Google) | ~/.gemini/settings.json → mcpServers | ✅ 面板点一下 |
| Antigravity | 桌面 IDE(Google) | ~/.gemini/config/mcp_config.json → mcpServers | ✅ 面板点一下 |
| OpenClaw | 网关(JSON5) | ~/.openclaw/openclaw.json → mcp.servers | ✅ 含注释时拒绝改写 |
| Hermes Agent | CLI(YAML) | ~/.hermes/config.yaml → mcp_servers | ✅ 只换自己那块 |
| VS Code Copilot | IDE | portable 的 mcpServers | ➖ 手填 |
| Gemini 桌面应用 / 网页版 | 聊天客户端 | 不提供 MCP 配置 | ❌ 接不了(Google 侧桌面形态用 Antigravity) |
🇨🇳 国内主流
| 宿主 | 类型 | 配置位置 | 挂载 |
|---|---|---|---|
| MengBot | 机器人平台 | 应用内「设置 → MCP 服务器」/项目 .mcp.json | ⚠️ 给了 MEMORY_HOST_MENGBOT_PROJECT 才写项目文件 |
| Qwen Code | CLI(阿里,Gemini CLI 同源) | ~/.qwen/settings.json → mcpServers | ✅ 面板点一下 |
| Kimi CLI | CLI(月之暗面) | ~/.kimi/mcp.json | ✅ 面板点一下 |
| GrokBot | 桌面客户端 | ~/.grokbot/mcp.json / %APPDATA%\GrokBot\mcp.json | ✅ 面板点一下(官方未公开格式,按约定探测) |
| 智谱清言 / ZhipuAI | 桌面 / Web | 应用内添加 | ➖ 只探测,手填 |
| WorkBuddy | 桌面客户端 | 应用内添加 | ➖ 只探测,手填 |
| Cherry Studio | 桌面客户端 | 应用内「设置 → MCP 服务器」 | ➖ 无外部配置文件 |
☁️ 不用装进程
| 通道 | 用法 |
|---|---|
| 云端 bot / 远程 agent | POST /memory-eternal/api/mcp(Streamable HTTP,云端带 Bearer me_…) |
| 终端 TUI | npx -y -p memory-eternal dsh-memory tui —— 实时队列、全选、批量批/驳、长文读卡 |
| Web 面板 | dsh-memory open → http://127.0.0.1:7999:独立部署,审核 / 检索 / 备份 |
一次投影多处:dsh-memory mcp mount --host gemini,qwen,kimi(--host all 全挂)。字段名、示例与坑见 docs/INTEGRATIONS.md;Orca 启动器见 orca-plugin,编辑器扩展见 cursor-extension。
MCP 对外就是标准 stdio server,5 个工具:
memory_recall/memory_capture/memory_stats/memory_audit_list/memory_revise。没列到的客户端按上面那行 stdio 配置写即可。
我们不是这里最大的。 Mem0 有 6.9 万星和成熟团队,我们做的不一样的是写入路径: 人审闸门、物理三库分离、可指认的审计链,外加一本能自己核对"召回到底值不值"的记忆账本 —— 这些在表 1 的「治理」列里体现,而不是靠宣传。
在你自己的库上复跑:
node scripts/bench-search.mjs --rebuild   # 重建耗时 + p50/p95/max 延迟
node scripts/bench-recall.mjs             # 自建金标题 R@5 / Top1
dsh-memory ledger --days 30 --json        # 召回注入 / 沉淀调用 / 有用率
| 我们实测的基线(2026-11-12,2,943 张卡) | 数值 |
|---|---|
| 金标 109 题 R@5(内置 / bge-m3) | 96.3% / 99.1% |
| 金标 109 题 Top1(内置 / bge-m3) | 86.2% / 89.9% |
| 改写题 10 条 R@5(内置 / bge-m3) | 40% / 70% |
| LongMemEval-S 500 题 R@5(内置 / bge-m3) | 95.4% / 97.2% |
| 召回延迟(词法 / 语义) | 约 7 ms / 81 ms |
| 召回模型调用(内置语义) | 0 |
检索分 ≠ QA 分。表 2 我们两行是 检索 R@5;Mem0 的 94.4 是它自报的 LongMemEval QA(且是托管平台口径),两列不混比。
🔍 语义召回(默认内置,无需装模型)
新装默认就是内置语义:零安装、零网络、零费用,同义扩展兜底,开箱即用。三种部署方式:
| 方式 | 说明 |
|---|---|
| 内置语义(默认) | 零依赖;自建集 R@5 96.3%,改写题 40% |
| 本地 Ollama(推荐升级) | bge-m3 向量;R@5 99.1%,改写题 70%,延迟约 100ms(含冷启动;热态查询嵌入实测 28–35 ms) |
| 在线 API | OpenAI 兼容端点,按量计费 |
首次打开记忆库会走三步引导,并默认全开:记忆核心 / 自动沉淀 / 自动召回 / 核心记忆注入 / 工作记忆 / 内置语义。 设置页「语义召回」右上角可「🧭 引导」重新查看。细节见 docs/EMBEDDINGS.md。
🎨 皮肤与界面
五套皮肤,设置 → 通用 → 主题皮肤一键切换;选择会本地保存,刷新后保持。
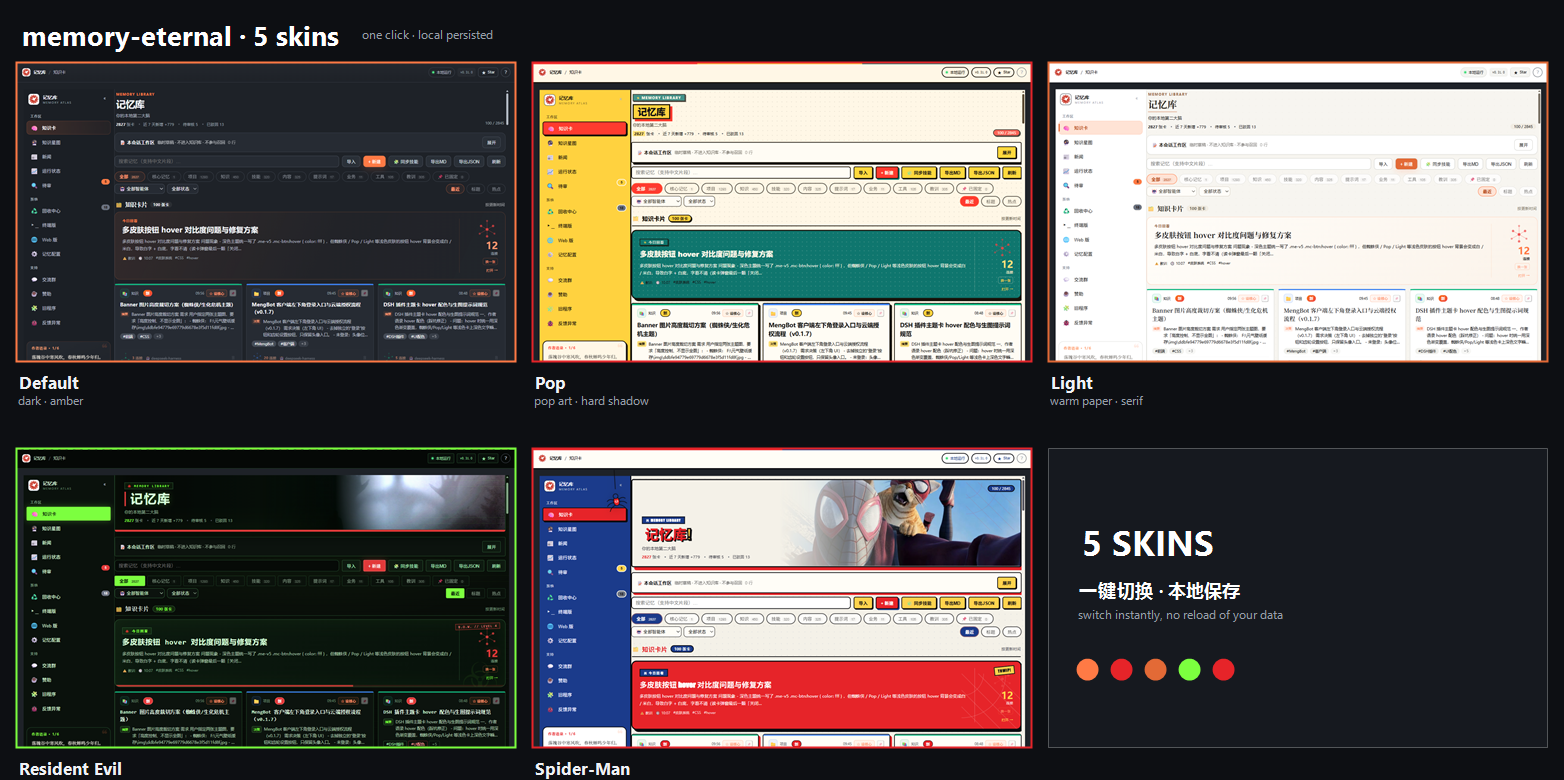
| 皮肤 | 风格 |
|---|---|
| 默认暗色 | 深色底 + 琥珀强调,长时间阅读不刺眼 |
| 波普 Pop | 黄底黑框、硬阴影、半调与粗黑标题 |
| 明亮 Light | 暖纸面 + 衬线标题,适合白天 |
| 生化危机 | Umbrella 实验室、毒绿扫描线、B.O.W. 头图与巨爪 |
| 蜘蛛侠 | 红蓝漫画、蛛网、半调、横版动作头图与悬吊挂件 |
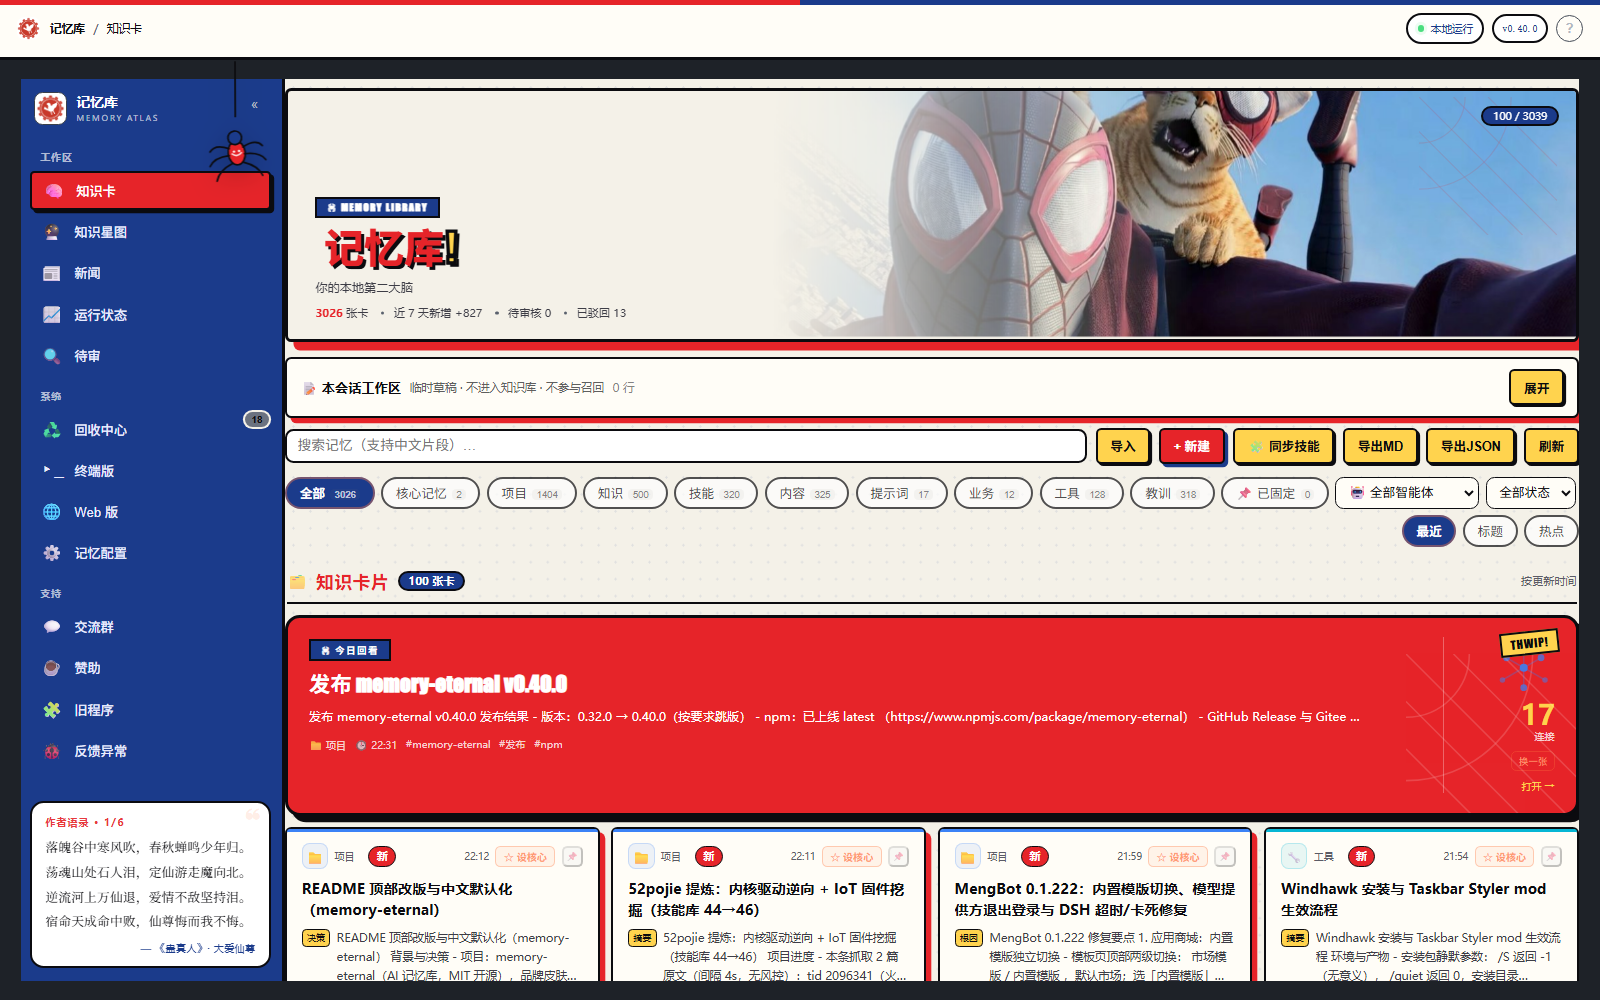
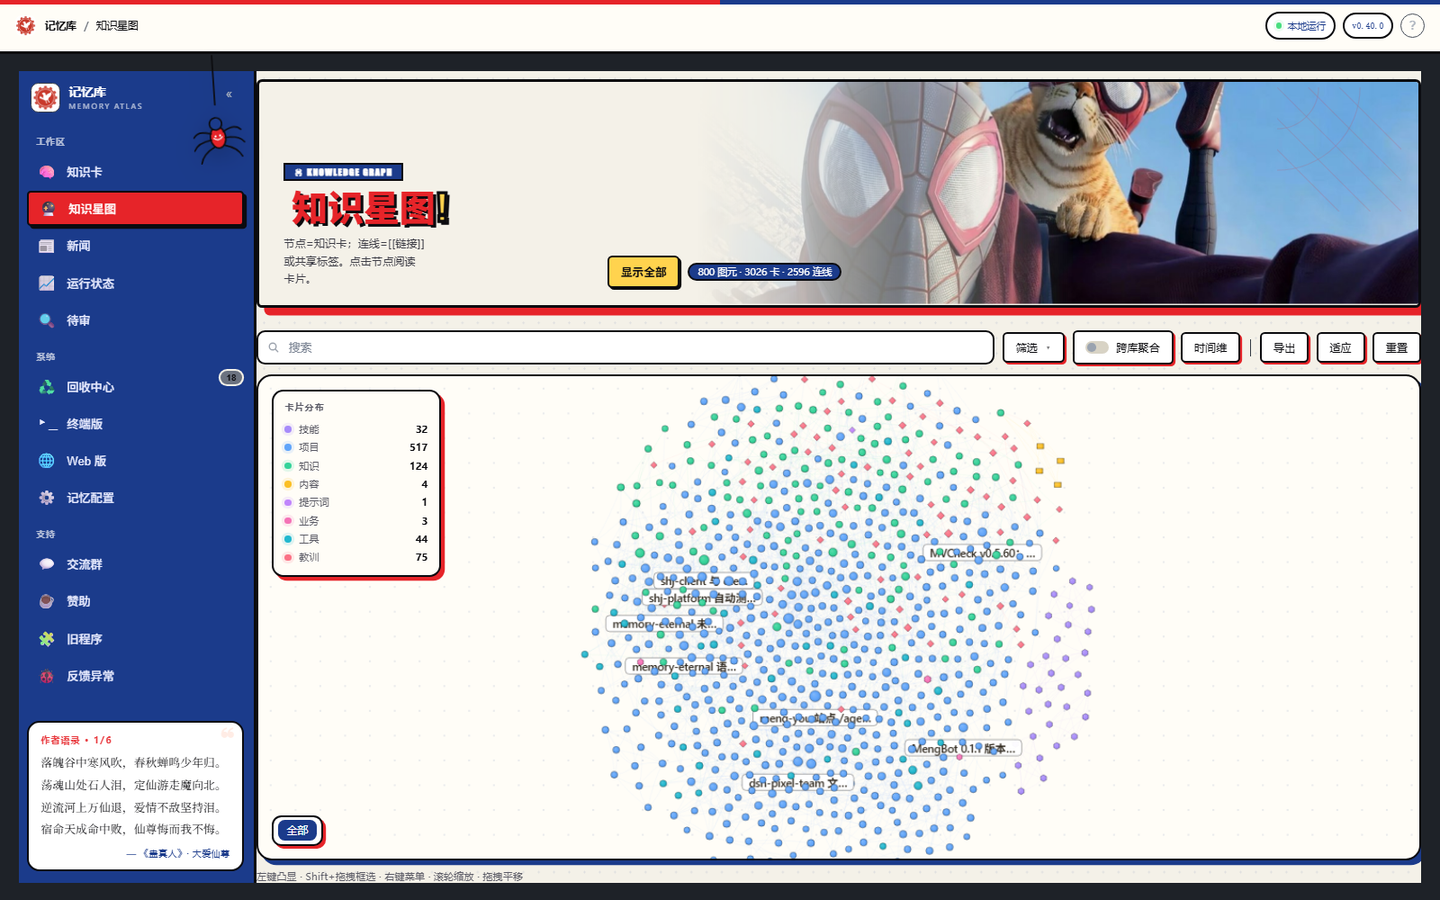
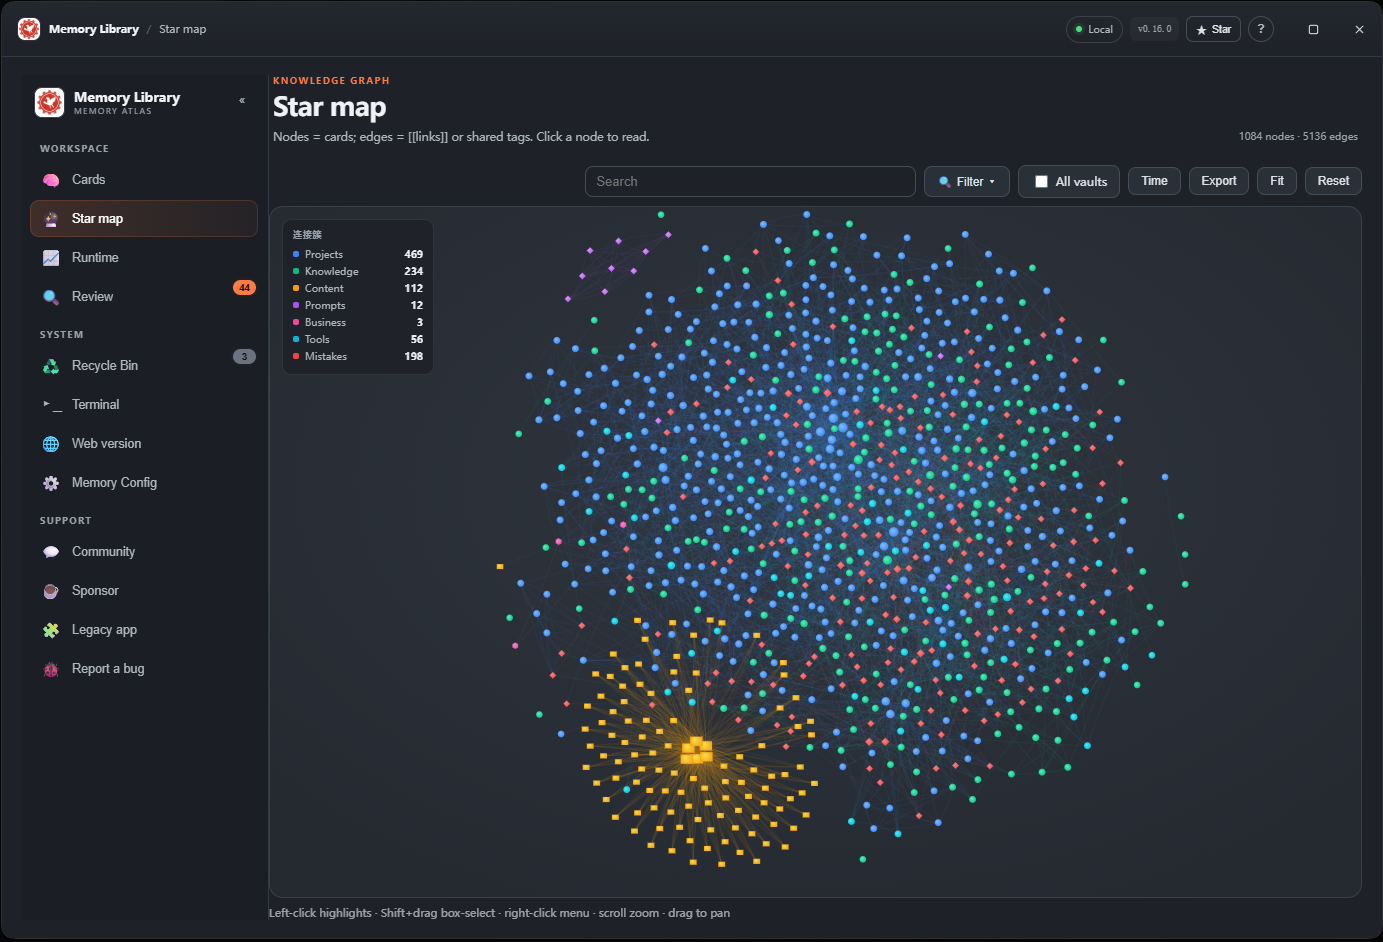
▲ 知识卡 · 知识星图 —— 在线 Demo
🏗 架构:一个库、一道闸门、两条读取路径
flowchart TB
  subgraph IF["接入层"]
    UI["DSH Web UI<br/>记忆库 · 星图 · 审核中心 · 设置"]
    MCPC["MCP 客户端<br/>Claude Code · Codex · Cursor · OpenClaw"]
    CLI["CLI / TUI<br/>dsh-memory"]
    CLOUDC["云端客户端<br/>换库 / 上传 / 下载"]
  end
  subgraph RT["插件运行时(宿主 Node 进程)"]
    HOST["index.js<br/>事件订阅 · 配置 · systemPrompt 注入"]
    API["lib/api.js<br/>HTTP API · SSE · CSRF · 审核接口"]
    CAP["capture.js<br/>采集 → 蒸馏 → 降级原文卡"]
    IDX["search-index.js<br/>清洗 · 同义扩展 · FTS5 BM25"]
    EMB["embeddings.js<br/>向量 · 覆盖率门控 · 融合"]
    VAULT["vault.js<br/>读写 · 审核 · 审计 · 回收站"]
    MCPL["mcp.js + hooks<br/>工具注册 · 会话事件"]
  end
  subgraph DB["本地存储(SQLite WAL + 文件)"]
    CARDS[("cards<br/>仅 approved")]
    QUAR[("quarantine<br/>pending / rejected")]
    FTS[("cards_fts<br/>FTS5 索引")]
    VEC[("card_vec<br/>可选向量")]
    LOG[("audit_log · ledger · revisions")]
    MD["Markdown 镜像 + 每日备份"]
  end
  subgraph EX["可选外部服务"]
    LLM["蒸馏 LLM<br/>宿主 provider"]
    OLL["Ollama :7997<br/>或任意 OpenAI 兼容 embedding"]
  end
  subgraph SV["云端实例(memory-eternal-cloud,可选)"]
    TENANT["resolveTenant()<br/>一个 owner 一个独立库"]
    CV[("cloud-vaults/owner/<br/>memory-eternal.db")]
  end

  UI --> API
  MCPC --> MCPL
  CLI --> VAULT
  CLOUDC --> API
  HOST --> CAP
  CAP --> LLM
  CAP --> VAULT
  VAULT --> CARDS
  VAULT --> QUAR
  VAULT --> LOG
  QUAR -->|人工批准| CARDS
  CARDS --> FTS
  CARDS --> VEC
  IDX --> FTS
  EMB --> VEC
  EMB --> OLL
  HOST -->|systemPrompt / memory_recall| UI
  VAULT --> MD
  API -->|Bearer 令牌| TENANT
  TENANT --> CV
这张图之所以成立,是因为三条不变量写在代码里,不是写在文档里:
| 不变量 | 由什么保证 |
|---|---|
| 主库物理上只存 approved | 两张物理表;所有读取路径只查主库 |
| Agent 永远不能批准自己的记忆 | Agent 只能写进隔离区;批准 / 驳回是 UI / TUI / CLI 里的人工动作 |
| 召回零模型调用 | FTS5 + BM25;LLM 只在沉淀时运行 |
云端只加了一条边:
API → resolveTenant() → 该 owner 自己的库。租户之间没有共享表,串不了数据。
🔁 一次会话里,到底发生了什么
宿主的 agent 不是「读写一个文件夹」,而是走一条有预算、有闸门、可降级的链路:
| # | 时刻 | 谁在动 | 具体动作 | 阻塞对话吗 |
|---|---|---|---|---|
| 1 | 会话建立 | index.js | 往 systemPrompt 装配若干段:核心记忆(order 120,≤6 张 / ≤2000 字)、当前会话草稿、自动召回规则段(order 600)、新闻摘要(可选)。核心记忆每 5 秒重算一次,内容没变就不重建 | 否 |
| 2 | 你提问 | 宿主 agent | 正常推理。用不用记忆由它自己决定 —— 规则段只是告诉它「什么时候该查」 | — |
| 3 | agent 主动召回 | memory_recall 工具 | 进程内直调 vault.search(),不经过 HTTP 端口;默认 5 条、每条摘要 130 字,工具超时 20s | 是(仅这一步) |
| 4 | 作答 | 宿主 agent | 召回结果就是一段普通工具输出,和读文件没区别 | — |
| 5 | 轮次结束 | agent/turn-stopping | 会话事件入队 → 按字符上限截尾 → 连续轮合并(几轮攒一次 LLM 调用,而不是每轮一次) | 否(serial 事件里刻意不 await LLM,避免拖慢收尾) |
| 6 | 蒸馏成卡 | 宿主 LLM(ctx.get('llm')) | 一段对话 → 一张卡;不足 captureMinChars=120 字跳过;同会话 60s 冷却;输出上限 max_tokens=4000 | 否(后台任务) |
| 7 | 去重判定 | pickNeighbors() | 只取最相关 8 张已有卡(DEDUP_NEIGHBORS)喂给模型,让它选「新建」还是 append_to 追加(近重阈值 0.62) | 否 |
| 8 | 落库 | vault.js | 写进 quarantine(status=pending),主库一动不动 | 否 |
| 9 | 人工审核 | 你 | 审核中心批准 → 进 cards → 建 FTS5 索引(5 分钟对账)+ 需要时补向量(batch 16) | — |
一句话概括分工:agent 负责「提议」和「按需取用」,永远不决定什么能进主库。
📥📤 两条读取路径
「两条」指的是上下文成本完全不同的两种读法,别混为一谈:
| 推送(push):systemPrompt 注入 | 拉取(pull):memory_recall 工具 | |
|---|---|---|
| 谁触发 | 插件自动,每轮都带 | agent 自己决定 |
| 带什么 | 核心记忆(≤6 张 / ≤2000 字)+ 规则段 + 会话草稿 | 命中 Top-N 卡片的标题 / 路径 / 摘要 |
| 预算 | coreMemoryLimit / coreMemoryMaxChars 硬上限 | recallLimit(默认 5,上限 20)× recallSummaryLen(默认 130 字) |
| 随卡片数增长吗 | 不增长(上限写死) | 不增长(条数与字数写死) |
| 典型用途 | 「不要做的事」「我的偏好」这类每次都必须遵守的约束 | 查历史决策、踩坑记录、项目背景 |
需要看正文时才有第三条路:
recallIncludeBody=true会给每条命中追加 ≤800 字正文摘录 —— 默认关闭,就是怕把上下文撑大。
💰 谁在什么时候调用模型
| 时机 | 调谁 | 同步/异步 | 失败会怎样 |
|---|---|---|---|
| 召回(默认) | 不调模型:FTS5 + BM25 全在 SQLite 里 | 同步 | 索引异常 → 全表兜底扫描 |
| 召回(开了语义) | Ollama bge-m3 算 1 次查询向量 | 同步,超时 15s | 60s 失败冷却 → 自动退回纯词法 |
| 召回(开了 rerank) | 你配的重排模型,只看 Top-30 候选 | 同步,超时 20s | 保留原排序 |
| 每轮沉淀 | 宿主 LLM 蒸馏(喂 8 张近邻卡) | 异步 | 存原文卡(零蒸馏成本),仍要人审 |
| 建向量缓存 | Ollama,batch 16 | 异步 backfill | 覆盖率不到 30% 就不启用语义路 |
🚀 卡片变多了,会变慢 / 变蠢吗?
这是最该被量化的担心,所以给数字,不给形容词。下面这张表由仓库自带脚本在临时合成库上跑出来(Windows / node v24.19.0 / 2026-11-18;每卡正文约 1600 字,dim=768):
| 卡片数 | FTS/BM25 | 向量打分 | 端到端 search() | 向量读入 | 单次召回注入字符 | 全库正文 |
|---|---|---|---|---|---|---|
| 200 | 0.31 ms | 1.2 ms | 28 ms | 0.6 MB | 283 字 | 0.32 M 字 |
| 1 000 | 0.90 ms | 11.4 ms | 38 ms | 2.9 MB | 286 字 | 1.60 M 字 |
| 2 000 | 1.61 ms | 25.8 ms | 43 ms | 5.9 MB | 304 字 | 3.21 M 字 |
| 5 000 | 3.55 ms | 55.5 ms | 71 ms | 14.6 MB | 307 字 | 8.01 M 字 |
(同一台机器上多跑几次,耗时会有 ±20% 左右的抖动 —— 量级与曲线形状才是有意义的部分,绝对值不必抠。)
自己复现(只写系统临时目录,不碰你的库):
node scripts/bench-capacity.mjs                  # 默认 200,1000,2000,5000
node scripts/bench-capacity.mjs 500,5000,20000   # 自定义规模
容量用
bench-capacity.mjs(自带合成库,测耗时与注入量);质量另用bench-recall.mjs(读--vault快照 + 金标集,测 R@5 / MRR / Top1)。两个脚本故意分开,别拿容量数字冒充质量结论。
结论一:上下文成本与卡片数无关。 卡片从 50 张涨到 5 000 张,单次召回注入仍是 300 字上下 —— 因为 limit=5 与每条 130 字是硬截断。作为对照,把全库正文直接塞进去是 8.1 百万字,差 4 个数量级。agent 看到的永远是「5 条摘要」,不是「一座图书馆」。
结论二:检索耗时增长远慢于直觉。 5 000 张卡时词法召回 3.6 ms、端到端 71 ms。词法是倒排索引 + 候选池固定 80 条(max(limit×4, 80)),不随库线性膨胀。
结论三:唯一真正线性增长的是向量打分。 没有 ANN 索引,就是「读全表 BLOB + 逐个 cosine」:5 000 张要读 14.6 MB、约 55 ms。这张表里增长最快的就是它。
于是可以给出可执行的容量口径:
| 库规模 | 建议 | 理由 |
|---|---|---|
| ≤ 5 千张 | 全开:词法 + 语义 + rerank | 向量打分数十毫秒,可无感 |
| 5 千 – 1 万 | 词法 + rerank 常开;语义改成按需 | 9 752 张实测:cosine 124 ms / 读 38 MB,端到端约 300 ms |
| > 1 万 | 词法 + rerank;语义只在分库后开 | 分库是唯一能真正压住线性项的手段 |
🧪 真实库实测:9 752 张卡的一次索引事故
比合成数据更值得读的,是一次真实排障。
库里 9 752 张已批准卡,cards_fts 却只有 50 行 —— 索引在某次批量导入之后就没再补齐,而召回在索引缺失时会静默退到「全表扫描 + 子串计数」兜底。于是同一条查询给出两种答案:
| 查询 | 索引只剩 50 行时(兜底扫描) | 重建索引后(FTS5 + BM25) |
|---|---|---|
审核 红线 批准 | 「DSH 记忆库巡检现状…」无关 | 「审核中心 #27 可就地查看正文 + 批准/驳回」✓ |
Ollama 语义召回 | 「autokill-purge 模型清单…」无关 | 「本地 Embedding 服务(Ollama/bge-m3)离线部署」✓ |
npm 发布 403 账号冷却 | 「0.47.0 发版前收尾…」勉强相关 | 「v0.49.13 发布记录与 npm 冷却问题」✓ |
这就是「agent 变蠢」的真实长相:不是卡片多,是索引没了。功能不报错、搜索不报错,只是答案变得像随机抽卡。
| 指标(真库 9 752 张) | 实测 |
|---|---|
| 词法召回(重建后) | 2.5 – 4.3 ms |
| 重建索引 | 3.5 – 9.8 s(一次性,9 752 行) |
| 全表 cosine(灌满 9 752 条 dim=1024 向量,读 38.1 MB) | 124 ms |
| 端到端召回(开语义,含 1 次 Ollama 查询嵌入) | 250 – 314 ms |
| 单次召回注入上下文 | 约 1 350 字(5 条 × 标题 + 路径 + 130 字摘要),与卡片总数无关 |
代价结构一目了然:词法几乎免费,语义每万张约 0.3 秒。
Ollama 的账另外算:本机 bge-m3 热态一次查询嵌入实测 28–35 ms(dim=1024),但它只在你开启语义召回时、每次召回调 一次,且与库大小无关 —— 慢的是「把库读一遍算相似度」,不是模型本身。冷启动另有一次性开销(模型首次加载)。
至于「会不会变蠢」:变蠢的机制从来不是「卡多」,而是坏卡挤进那 5 个名额。所以真正的防线是闸门而不是容量:
- 只有人批准的卡才进主库(
quarantine物理隔离 232 张待审也影响不到召回); - 沉淀时先做近重判定(阈值 0.62),重复内容会被
append_to合并而不是堆成新卡; - 召回结果可以点「有用 / 没用」,反馈直接参与排序(
有用×2 − 没用的×2); - 过时卡归档后物理上不参与召回;
- 判断标准写在账本里:有用率长期低于 60%,就调小
recallLimit/recallSummaryLen,或者直接关掉记忆 —— 这是插件自己给出的退场条件。
🧰 运维:索引和向量什么时候要手动补
索引只在写卡那一刻逐条维护(indexCardById / unindexCard)。批量导入、Markdown 迁移、跨版本升级进来的存量卡不会自动补 —— 这是当前实现的已知缺口,所以要自己查一次:
node scripts/reindex-fts.mjs          # 只报告:已批准卡数 vs 已索引行数
node scripts/reindex-fts.mjs --force  # 重建(只写 cards_fts / _fts_rows,不动卡)
| 症状 | 判断依据 | 处理 |
|---|---|---|
| 命中有「随机抽卡」感 | cards_fts 行数 < cards 行数 | 上面两行命令 |
| 语义召回像没开 | card_vec 覆盖率 < 30%,门控会静默关掉 | 面板 → 语义召回 → 补向量(batch 16) |
| 越用越慢 | 索引缺失时每次召回都走全表扫描 | 同上,先重建索引 |
反过来的情况也要知道:索引建全、向量灌满之后,召回会从「全表兜底」切到「FTS + 语义融合」,单次耗时从几毫秒升到约 300 ms(1 万张、dim=1024)。这是花了时间换准确度,不是变慢的 bug —— 觉得不划算就把语义关掉,词法路径照常。
🧯 任意一环挂了会怎样
| 失败点 | 自动行为 | 你看到的现象 |
|---|---|---|
| Ollama 没启动 / 端口不通 | 60s 失败冷却,退回纯词法 | 召回照常,只是同义词弱一些 |
| 向量覆盖率 < 30% | 不启用语义路 | 同上(避免"半库向量"污染排序) |
| rerank 未配置 / 超时 | 保留原排序 | 无感 |
| 宿主 LLM 不可用 | 存原文卡,标记降级 | 卡片变「原始对话」,仍要人审 |
| FTS 索引异常 | 全表兜底扫描 | 召回变慢但仍能搜到 |
| 库文件损坏 | 每日备份 + auto-restore | 启动时自动回滚到最近可用备份 |
🔗 MEM Pair:两个记忆库互配对、互传卡(v0.49.10)
本机常常同时跑着多个 memory-eternal:运营库(7999)、隔离运营的 mem-purge(7989)、云端实例。 它们各有独立 SQLite,不能共享一个库;但你需要让它们互相喂料(运营口径 → purge,purge 的清理结论 → 运营库)。
MEM Pair 就是这套「显式、可审计、默认不打扰」的通道:
| 阶段 | 怎么做 | 判定信号 |
|---|---|---|
| 发现 | 局域网 UDP 广播(默认 7990),或直接填 host:port | 面板列出对方名字 + 匹配码 + 指纹 |
| 首次配对 | 一端发起 → 另一端面板弹窗确认(显示 6 位握手码,两边肉眼核对) | 双方配对表里都出现对方 |
| 之后再连 | 只需要匹配码:对方认得这个码且指纹没变 → 直接建立,不再弹窗 | 面板显示「已配对 → 对方」 |
| 指纹变了 | 对方重装 / 可能被冒充 → 回到人工确认,弹窗标红 | 必须重新点确认 |
| 传数据 | 「上传」(本库 → 对方)/「下载」(对方 → 本库),一律进对方待审队列 | 计数:sent / written / failed |
dsh-memory peer code                                  # 我的匹配码
dsh-memory peer pair 192.168.1.20:7989                # 首次配对(对方要确认)
dsh-memory peer connect 7K2M-Q9FA --host 192.168.1.20 --port 7989   # 之后只凭码重连
dsh-memory peer upload   --to 7K2M-Q9FA               # 推卡过去(进对方待审)
dsh-memory peer download --from 7K2M-Q9FA             # 拉卡回来(进本库待审)
安全口径:共享密钥由两端各自算出(一次性 ephemeral 派生,长期密钥永不上网);每个请求带 HMAC 签名 + ±5 分钟时间窗 + nonce 去重;对方推来的卡只能进待审,不会直接污染已审库。
🔌 Agent MCP 挂载(一份标准,六种宿主)
作为 DSH 插件安装时,默认就把 MCP 挂到 DSH 自己(~/.dsh/mcp-servers.json),装好即用;
Claude Code / Codex / Cursor / Windsurf 这些「你另开的宿主」必须手动挂 —— 否则同一个仓库里
被多个 agent 读到不同库,沉淀与召回就会串味。
所有宿主共用同一个标准(一处声明 → 各自渲染):server 名固定 memory-eternal、只用 stdio、
命令写绝对路径、参数走 env、幂等写入且只增删自己那一条、写后回读校验、能检测「指向旧包路径」的漂移。
dsh-memory mcp status                                   # 状态 + 各宿主矩阵
dsh-memory mcp mount --vault ~/.dsh/memory-vault        # 挂本机库(默认只写 DSH)
dsh-memory mcp mount --url http://127.0.0.1:7989 --host dsh,claude   # 一次投影多个宿主
dsh-memory mcp mount --vault <库> --host all            # 所有已安装宿主
dsh-memory mcp unmount                                  # 从所有已挂载宿主摘掉(幂等)
面板:设置 → 🧪 实验性 → 🔌 Agent MCP 挂载(v0.49.10 起是列表点击式)
● 2 / 6 已挂载 → 本机默认库                       [刷新] [自检]
  ⬤ 装成 DSH 插件时自动挂载   默认开启,装好即用…

挂哪个库(点一行选中)
  ● 本机默认库   已选中        ○ mem-purge  9DUW-QPVM       ○ 云端  5EZK-RWM5

挂到哪些宿主(点哪行就挂/摘哪行)          [全部挂载] [全部卸载]
  ● DeepSeek Harness (DSH)  已挂载   …\.dsh\mcp-servers.json        卸载
  ○ Claude Code             未挂载   …\.claude.json                 挂载
  ○ Claude 项目级 .mcp.json  未挂载   …\.mcp.json                   挂载
                展开其余 3 个宿主
- 默认只显示 3 个宿主,多出来的收进「展开其余 N 个宿主」;
- 每行状态一眼可辨:实心绿=已挂载 / 空心=未挂载 / 虚线圈=未安装(未安装置灰不可点);
- 「自检」按钮会真的拉起一次 MCP 进程做 initialize 握手,把
ok / 耗时 / 启动命令 / stderr直接显示出来 —— Windows 上"路径不对、宿主识别不了"当场就能看到原因; - Windows / Electron 兼容:条目里的 node 不再取
process.execPath(在 DSH 这类 Electron 宿主里那是宿主自己的 exe),而是走 PATH 解析 + 校验存在性;写盘前统一反斜杠绝对路径,脚本不存在直接拒绝写入(不留死条目); - 想彻底关掉自动挂载:配置
mcpAutoMount: false,或环境变量MEMORY_MCP_AUTOMOUNT=0。
🧷 多实例并行:端口、库文件名、vault 目录
同一台机跑多个 memory-eternal(比如运营库 + 某个项目的隔离库)时,三个维度都能分开:
| 维度 | 怎么设 | 默认 |
|---|---|---|
| 端口 | dsh-memory open --port 7989 / serve --port 7989 / 环境变量 MEMORY_WEB_PORT=7989 / 配置项 webPort | 7999 |
| 库文件名 | 环境变量 MEMORY_DB_FILE=mem-purge.db | memory-eternal.db |
| vault 目录 | --vault <dir> / 配置项 vaultDir / vaultProfiles 多库切换 | ~/.dsh/memory-vault |
# 第二个实例:端口 7989、库文件 mem-purge.db、独立 vault
DSH_HOME=~/.dsh/memory-vault-mem-purge \
MEMORY_WEB_PORT=7989 \
MEMORY_DB_FILE=mem-purge.db \
node $(dirname $(which dsh-memory))/../lib/web.js --port 7989 --vault ~/.dsh/memory-vault-mem-purge
两个安全口径:
- 库文件名只接受纯文件名(字母数字
._-,必须以.db结尾),带路径分隔符一律退回默认名 —— 不会因为一个环境变量把库写到别处; - 设了自定义名、但该目录里已经是
memory-eternal.db的库 → 继续用标准名,避免"改了个环境变量结果打开空库、以为数据丢了"。
📚 文档与链接
- 完整手册(中文) · Full manual (English)
- 云端多租户与部署 · 私有化部署(Docker / systemd) · 私有组件边界
- 更新日志 · 架构细节 · 主题皮肤
- 📚 全部文档索引 —— 接入 / 运维 / 历史发版说明按目录归档
- 终端插件(dsh-tui) · Orca 启动器 · Cursor / VS Code 扩展
- 反馈问题
💬 交流群
遇到问题、想提需求、或者想聊聊 DSH 插件开发 —— 欢迎进群:
| QQ 交流群 | 微信交流群 |
|---|---|
 |  |
如果这个插件帮你省了时间,可以请作者喝杯咖啡(微信 / 支付宝任选其一):
| 微信收款码 | 微信赞赏码 | 支付宝 |
|---|---|---|
 |  |  |
打赏完全自愿,不影响任何功能;插件本体始终开源免费(MIT)。详见 SPONSOR.md。
📄 License
MIT —— 随便用、随便自托管、随便二次开发。
🖋 作者语录
「大爱」二字,是全篇最大的反讽。面板左栏底部同步轮播。
落魄谷中寒风吹,春秋蝉鸣少年归。
荡魂山处石人泪,定仙游走魔向北。
逆流河上万仙退,爱情不敌坚持泪。
宿命天成命中败,仙尊悔而我不悔。
早岁已知世事艰,仍许飞鸿荡云间。
男儿不展凌云志,空负天生八尺躯。
天河一挂淘龙鱼,逆天独行顾八荒。
今朝暂且展翼去,明朝飞仙笞凤凰!
——《蛊真人》· 大爱仙尊
🌟 贡献者
感谢每一位让记忆核心更好用的人。
| 贡献者 | 贡献 |
|---|---|
| @aloneangel45 | 发现并修复 #54 —— tools 服务晚挂载时 memory_recall / memory_note 从未注册(#58) |
| @EternalNight996 | 作者与维护者 |
有想落地的修复?欢迎开 issue 或 PR —— 每个被合并的贡献都会出现在这里。